AI時代のデザインの中核スキル:批評
有用でユーザブルなAI搭載システムを構築するには、ユーザーニーズに対する我々の理解とデザイン上の判断を、明確に定義された評価基準に落とし込む必要がある。
生成AIシステムにおけるデザイン上の決定
大規模言語モデルに「今日の天気は?」のような質問をするとしよう。その返答では、情報が多すぎることもあれば(「気温は22度で、風冷えを考慮した体感温度も22度です」)、少なすぎることもある(「外は気持ちいいですよ!」)。また、降水確率が30%のときに、「雨は降りそうにありません」と返ってくるかもしれない。この確率は確かに50%は切っているが、それでも、ほとんどの人が知っておきたいと思うほどには高いだろう。AIは、回答に何を含めるか、そしてそれをどのように表現するかについて、デザイン上の決定を行っている。AIモデルが行う可能性のあるデザイン上の決定を我々がすべて指定することはできない中で、そうしたデザイン上の決定が「正しい」もの、つまり、調査や対象ユーザーについての我々の理解に基づき、ユーザーのニーズに最もよく応えるものになるようにするにはどのように働きかければよいのだろうか。
決定論的システムから確率的システムへの移行
この問いに答えるために、AI非搭載システムを開発する際、デザイン仕様が従来どのように使われてきたかを考えてみるとよい。基本的に、デザイナーである我々は、エンジニアリングや品質保証の担当者が我々の仕様を読んで、我々が指定したとおりの振る舞いを実現するコードを書いてくれることを期待している。また、そのコードが仕様どおりに動作することを検証するテストを作成してくれることを期待している。Figmaのようなツールによって、特定の種類のUIコードやテストを自動生成できるようになり、このプロセスは簡略化されたが、これが基本となる開発モデルである。
AIを搭載していないソフトウェアアプリケーションの振る舞いを厳密に指定できる理由は、その決定論的な性質にある。決定論的なコードは、同じものを入力して実行すると、常に同じ出力を生成する。それに対して、AIモデルは非決定論的である。つまり、同じ入力が与えられても、同じ出力が得られる保証はない。これがAIの柔軟性の源ではあるが、同時に、厳密な仕様に従うことを期待できないということでもある。
デザイナーは「よい」とは何かを定義しなければならない
ここでデザイン批評が重要になる。デザイナーとしての我々のタスクを、モデルの振る舞いを厳密に指定することから、「よい」とはどのようなものか(そして、どのようなものでは「ない」のか)を定義することであると捉え直せば、モデルの振る舞いが我々の意図にどの程度沿っているかについて、エンジニアリングやデータサイエンスの担当者が評価できる仕組みを作ることができる。「よい」の定義は、これまでどおりユーザー調査とデザインの専門知識から得られる。つまり、観察された行動、言語化されたニーズ、不満のパターンをデザインの視点を通して解釈することで定義できる。我々は、その「よい」の定義を別のかたちで表現しているにすぎない。
以下の例は、対話型システムをデザインしている私自身の経験の中から取り上げたものだが、このアプローチは主に生成AIによって動作するあらゆるシステムのデザインに一般化できると考えている。
判定・評価・反復
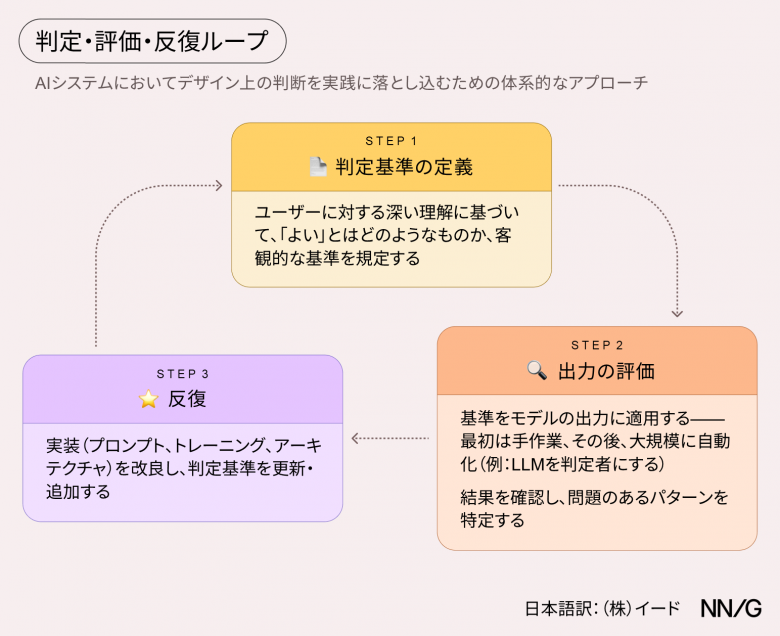
対話デザイナーとしての私自身の実務では、判定・評価・反復ループを導入した。まず、システムの出力が我々の「よい」の定義を満たしているかどうかを評価するための判定基準を定義する。次に、その基準を使って実際の出力を評価する。最後に、その評価結果を使って改善すべき領域を特定し、データサイエンスとエンジニアリングの担当者と協力して実装を改良する。さらに、望ましくない振る舞いの新たなパターンを特定するたびに、それをもとに追加の判定基準を定義し、ループを再開する。
1つ注意点がある。このプロセスは対話型の体験ではうまく機能するが、視覚中心の体験には適用しにくい可能性がある。システムの入出力を記録し、それらを評価モデルで「リプレイ(再現)」することは、入力と出力の両方がテキストであれば比較的容易だが、グラフィカルな入力と出力を評価用データセットでどのように表現すればよいかはまだ明確ではないからだ。それでも、AIモデルがテキストや音声に加えて視覚入力も解釈できることは明らかであり、アクセシビリティスキャナーやデザインシステムリンターのようなツールの進歩によって、評価能力も進化していくと我々は考えている。
1. 判定基準の定義
このプロセスの最初のステップは、モデルの特定の出力を評価し、それが許容できるものかどうかを判断するための、一連の判定基準を定義することである。こうした基準は、デザイナーが最も主体的に決められる部分だ。最終的にこれらの基準は、想定する顧客のニーズやユースケースに応えるために、システムがコンテキストやリソースをどのように利用すべきかについての我々の理解を表すものになる。
判定基準を作成する上で最も重要なのは、可能な限り客観的にすること、ただし恣意的にはしないことである。もともと客観的な基準もある。たとえば、特定の情報が回答に含まれているかどうかは評価が容易であり、異なる判定者の間でも、人間かAIかを問わず、非常に一貫した判定が得られる。一方、客観的に定義するのが難しい基準もある。たとえば、音声による対話をデザインする場合は、回答の「発話量」、つまり回答の長さが重要になることが多い。これは客観的に評価するのが容易ではない。長年の調査とユーザー観察から、「発話量が多すぎる」とされる長さは、状況やユーザーによって異なることがわかっている。そのため、恣意的なしきい値(たとえば、「回答は10秒未満でなければならない」)ではうまくいかない。照明を消すという単純な依頼には、5秒の回答でも長すぎるとみなされかねないが、複雑なオープンエンド型の質問なら、20秒の回答でも短すぎることがあるからだ。
とはいえ、出力を「長すぎると感じる」かどうかを評価者に尋ねる方法もうまくいかない。どのくらいだと「話が長すぎると感じる」かは、人によって(あるいは、AIモデルによって)それぞれ意見が異なる。基準があいまいだと、評価者自身がデザイン上の判断を下さざるをえない。そして、その判断は主観的なものになってしまう。
私はこの問題に2段階のアプローチで対処している。まず、回答をさまざまなタイプに分類するための基準を定め、次に、回答タイプごとに異なる評価基準を作成する。たとえば、オープンエンド型の質問への回答なら、「質問に十分に答え、関連性の高い追加情報を1~2個だけ含んでいる」場合に合格とする。この基準でも、ある程度の主観性は含まれるが(「十分に答えた」や「関連性が高い」が何を意味するかについての判断が評価者によって若干異なる可能性がある)、「ほとんど」の評価者の判断が「ほとんど」の回答で一致する程度には客観的である。このレベルの一貫性を確保することが、自動評価ツール(後述)を使用する場合には特に重要ということだ。
2. モデルの出力の評価
判定基準を定義したら、それをモデルの実際の出力に適用する。当初、この評価は人手で行うことになるかもしれない。つまり、人間がシステムを操作してその出力を記録して、その出力が判定基準を満たしているかどうかをアノテーション(ラベルづけ)する。
大規模に行うにはこのプロセスを自動化するとよい。ユーザーの入力を収集し、更新されたモデル、プロンプト、システムアーキテクチャで「リプレイ」することで、評価対象となる新たな結果を生成できる。また、AIモデルに、システムを「使用する」際のユーザーの行動をシミュレーションするよう、プロンプトで指示することもできる。ただし、AIの振る舞いは実際のユーザーの行動とは大きく異なるため、この手法は一般にはよりリスクが高いと考えられる。
評価については、判定基準をプロンプトに変換し、別のAIモデルを出力の判定者にすることが可能だ。「判定者としてのLLM」と呼ばれるこの方法では、LLM判定者を人間によるアノテーションを基準に慎重にキャリブレーションすることで、LLMによる判定を人間の評価者による判定とかなりよく一致させることができる。そうした評価の質を測る優れた指標の1つにF1スコア(LLMによってアノテーションされたデータセットを人間によるアノテーションと比較したときの適合率と再現率の平均)がある。経験上、F1スコア0.8を達成できるLLM判定者は、有用な評価結果を生成する上で十分信頼できる。
3. 実装と判定基準の反復的な改善
私は評価結果を用いて実装を改善する方法をこれまでいくつか見つけてきたが、通常はまず、さまざまな判定者によって失敗とみなされた出力例を確認することから始めている(一般に、「合格」率が低いものを優先する)。そうした失敗例を見ていくと、1)実際に失敗している回答の原因と思われる振る舞い、2)実際には失敗とは思えない振る舞い、という2つの振る舞いのパターンをよく目にする。
前者は、プロンプトエンジニアリングによって改善できる点を特定するのに利用でき、後者は、判定基準をどのように更新するかを決めるのに役立つ。
また、評価基準と失敗例そのものをLLMへの入力として与え、よりよい結果を得るためにプロンプトを最適化するよう求めることも可能である。このアプローチは、プロンプトを試行錯誤で調整するよりもうまくいくことが多く、より迅速に反復できる。
たまに、プロンプトエンジニアリングでは改善しにくいモデルもある。その場合には、同じプロンプトに対する「よい」回答と「悪い」回答のペアを作る方法がうまくいくこともある。これを行うには、「不合格」の回答を少数取り出し、我々の基準に合格するよう書き直す。そして、その回答ペアを使ってモデルをファインチューニングし、望ましい方向へ誘導する。
| 会話 | 判定スコアと根拠 | |
|---|---|---|
| 悪い例 | ユーザー:Tommyの誕生日をカレンダーに追加して。 システム:もちろんです。そうします。喜んでTommyの誕生日をカレンダーに追加します。Tommyの誕生日はいつですか。 | 不合格:システムがそのタスクを実行する意向を2回表明しており、「Tommyの誕生日」という表現も2回使っている。 |
| よい例 | ユーザー:Tommyの誕生日をカレンダーに追加して。 システム:もちろんです。そうします。Tommyの誕生日はいつですか。 | 合格:「Tommyの誕生日」を1回だけ繰り返しており、システムがユーザーの発言を正しく聞き取ったことを確認するのに十分である。 |
判定・評価・反復ループを実装するためのベストプラクティス
もちろん、このプロセスを実装する上では、さまざまな課題がある。以下では、私が見出したいくつかのベストプラクティスを紹介する。
すべてのLLM/AI判定者をキャリブレーションし、すべてのLLM/AI出力を検証する
AIモデルは、裏づけのない完全に捏造された出力をもっともらしく生成する能力が非常に高い。LLMを使えば、自動評価を迅速かつ大規模に行うことが可能だ。しかし、そうした自動評価を、代表性があり、人間がアノテーションしたテストセットを基準に慎重にキャリブレーションしなければ、そこで得られるデータはまったく役に立たない可能性がある。改善につながるのと同じくらい容易にパフォーマンスを悪化させかねない。LLMが生成したテストデータやプロンプトの最適化についても同じことが言える。人間による確認(少なくとも一部をサンプルとして確認すること)なしには、それらが成果につながる可能性は低いだろう。
複雑な評価基準を構成要素に分解する
評価基準は、多くの場合、複数の判定に分解することができる。たとえば、上で述べた発話量の例では、まず会話のタイプを分類し、「その後で」発話量を評価している。また、この方法を取れば、評価を単純化することもできる(その結果、より迅速に行えるし、コストも下げられる)。そうした構成要素には、それほど高性能なモデルを必要としないものや、決定論的なルールだけで処理できるものもあるからだ。たとえば、視覚的なUXの評価基準が「我々のビジュアルスタイルガイドに準拠していること」であれば、適切な書体、文字サイズ、ブランドカラー、WCAG基準を満たすカラーコントラストなどの要件ごとに個別に判定すればよい。
リグレッションに注意する
決定論的システムでは、いったんバグを修正すれば、関連するコードが変更されない限り、通常そのバグは修正されたままである。一方、AIでは、カオス理論が当てはまるように思える。つまり、重視している基準とはまったく関係がないように見えるプロンプトの変更やトレーニングデータの更新であっても、問題を引き起こす可能性がある。たとえ長期間にわたって良好な結果が得られていても、モデルやプロンプトに変更が入るたびに、重視する「すべて」の基準で評価を繰り返すことが重要である。
結論
対話型の体験をデザインしている我々は、今回紹介したようなデザインの進め方の最先端にいる。しかし、事前に定義された静的な体験から、AI駆動の動的な体験への移行による影響は、まもなくユーザーエクスペリエンス全般に及ぶだろう。この変化に対応し、質の高い体験を提供するには、我々は「よいデザイン」の裁定者としての役割を担う必要がある。そこでは単なる好みではなく、熟慮に基づく判断と確かなデザイン批評がよりどころとなる。そうした批評は、ユーザーについての深い理解と、「よい」とはどのようなものかについての厳密な定義に基づいていなければならない。
記事で述べられている意見・見解は執筆者等のものであり、株式会社イードの公式な立場・方針を示すものではありません。