コンテキストアーキテクチャ
コンテキストアーキテクチャは、情報アーキテクチャの原則をAIシステムに適用するものである。これにより、エージェントが情報を解釈し、より質が高く、ユーザーの意図に沿った応答を生成できるようになる。
プロンプトからコンテキストへ
AIプロダクトをかたちづくる方法は急速に進化してきた。
はじまりはプロンプトエンジニアリングだった。当初、成功するかどうかは適切な指示を作れるかどうかにかかっていた。よく書かれたプロンプトは驚くほど優れた結果を引き出すことがあり、チームはプロンプトを資産として収集し、再利用するようになった。
次に登場したのが、Tobi Lutkeが提唱した「コンテキストエンジニアリング」である。チームは、プロンプトだけでは不十分であり、重要なのは、目の前のタスクに合わせて選び抜かれた、簡潔な一連の指針だと気づいた。指示、取得した知識、特定の用途に特化したツール、選択したメモリー、システムの状態が、すべて連携して機能する。課題は、プロンプトを書くことから、コンテキストを統合・調整することへと移った。
現在、われわれはエージェント型システムの時代に入りつつある。エージェントは応答するだけでなく、ユーザーに代わってタスクを実行する。情報を取得し、ツールを呼び出し、状態を維持し、複数のステップにわたって行動する。自律性は高まり、多くの場合、ほかのエージェントとも連携する。
この変化によって、新たな設計課題が生じる。もはやモデルに何を言わせるかだけを定義するのではない。モデルが思考し、行動する環境そのものを設計するのである。
この課題に対処するうえで、なじみ深い領域である情報アーキテクチャが、新たなかたちで重要になる。コンテキストアーキテクチャである。
人類は何千年もの間、人が情報を理解し、その中をたどり、効果的に利用できるように情報を整理してきた。曖昧さを減らし、見つけやすさを高めるために、構造、タクソノミー、ラベリングシステム、ナビゲーションパターンを発展させてきた。LLMにも同じ基盤が必要である。
課題は、単に情報へアクセスできるようにすることではない。その情報を、人間と機械の双方にとって意味があり、構造化され、利用可能なものにすることである。
これこそが、コンテキストそのものに適用された情報アーキテクチャの役割である。
そしてAI時代には、それが中心的な役割を担う。
コンテキストが重要な理由
従来からあるデジタルプロダクトは決定論的である。フローを一段階ずつ設計し、そのフローに沿ったプロダクトの振る舞いを定義して、コードに組み込む。この方法では、毎回一貫した出力を得られる。システムは意図どおりに振る舞うため、考慮すべきことは、ユーザーがそれにどう反応するかである。
AIプロダクトでは、この構図が変わる。LLMは確率的であるため、同じ入力でも異なる出力が生じうる。その変動性はLLMの強みの一部だが、システムが生成する内容を完全には制御できないことも意味する。課題は、厳密な結果を定義することから、ユーザーがどう解釈し反応するかを考慮しながら、システムの振る舞いを方向づけることへと移る。
多くのチームにとって、学習データは直接制御できるものではない。外部で学習されたサードパーティー製モデルや基盤モデルに依存しているためである。その結果、コンテキストはシステムの振る舞いを方向づける主要な手段の一つとなる。指示、取得した知識、ツール、メモリー、状態はいずれも、モデルがタスクを解釈し応答を生成する方法に影響する。チームは、コンテキストの変更が実際にシステムの振る舞いを改善したかどうかを測定できる。
コンテキストのエコシステム
コンテキストは、単なるシステムプロンプトの一覧ではない。発見し、選択する必要がある情報のエコシステムである。AIシステムのコンテキストウィンドウ内にあるすべてがコンテキストに当たる。そこに常時存在する場合もあれば、保存された情報から取得され、モデルの出力を方向づける場合もある。
現代のAIシステムでは、コンテキストは複数の情報源から動的に組み立てられる。
- システム指示とガードレール:システムが何をすべきか、何をすべきでないかについて、デザイナーやエンジニアが与える指示である。エンドユーザーには見えず、企業は望ましい結果へ導くために利用する。
- ナレッジベースから取得した情報:データベースなどの知識源から、しばしばRAG(検索拡張生成)を通じて取得される情報である。AIシステムは、指示を受けると関連情報を検索・取得し、その内容に基づいた応答を生成する。
- スキル:エージェントが必要な場合にだけ読み込む、再利用可能な指示、スクリプト、リソースのパッケージである。通常はスキル名と説明だけが読み込まれ、呼び出されたときに、スキルの全内容が提示される。
- ツール:AIシステムが、コンテキストウィンドウ外の情報にアクセスしたり行動したりするために呼び出せる外部機能である。ウェブ検索、カレンダー、データベース、APIなどが含まれる。こうした機能は、モデルがツールや外部リソースを発見し操作する方法を標準化するMCP(Model Context Protocol)を通じて提供されることが増えている。その有効性は、機能そのものだけでなく、ツールの説明、ラベル、分類、結果をコンテキストへ戻す方法にも左右される。適切に構造化されていないツール定義は、誤ったツールの選択、無関係な情報の取得、不要な操作の実行につながりうる。
- 長期メモリー:システムが複数の会話にわたって保持する情報、または長期的に記憶するよう明示的に指示された情報である。
- 会話(短期)のメモリー:一つのセッション内における直近のやり取りの履歴である。
- ユーザーのプロンプト:ある時点でユーザーが与える直接の入力である。
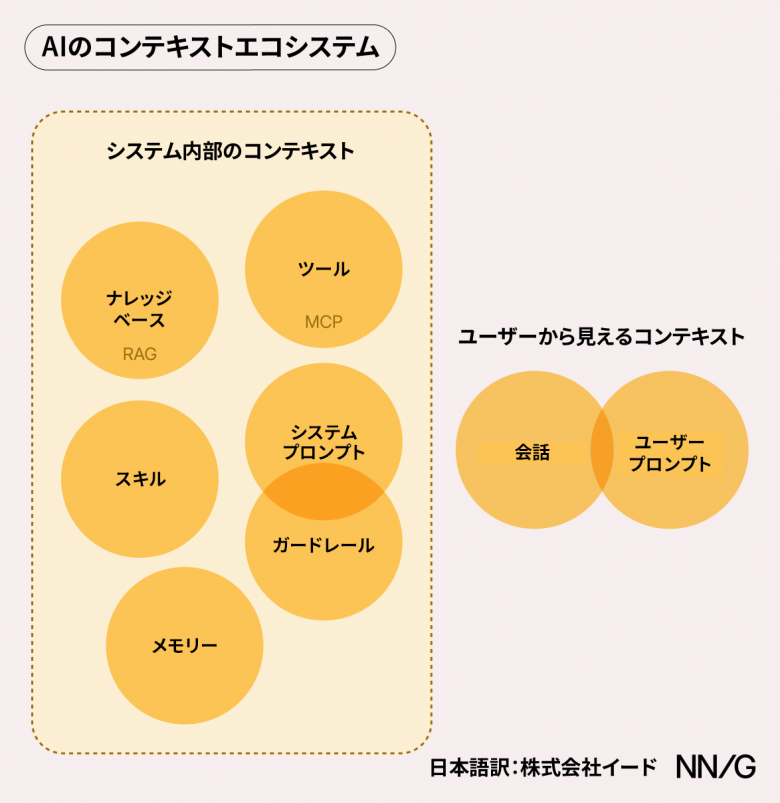
これらの要素には、自然言語、構造化マークアップ、コードが混在する。長く、多層的なものもある。
しかし、コンテキストを増やせば結果がよくなるわけではない。各要素がモデルの「注意」を奪い合うからである。人間と同様、モデルも情報過多の影響を受ける。
適切に構造化されていないコンテキストは、システムを遅くし、コストを増やし、一貫性のない出力や誤りを招く。明確な構造と優先順位づけは、内容そのものと同じくらい重要である。
コンテキストエンジニアリングからコンテキストアーキテクチャへ
コンテキストエンジニアリングは、現在、開発チームがAIの振る舞いを方向づける方法である。AIシステムは一つの入力だけで動くのではなく、相互作用する複数のシグナルによって動くため、それらを選定し、維持する必要があるという認識に立つ。
ここでUX専門家が必要になる。
われわれは、物理的なシステムでも同じ構図を見てきた。UXの分野に移る前、筆者はニューヨーク市の公立学校を設計する建築家であった。エンジニアは、配管が機能し、電気が流れ、構造が保たれるようにした。一方、建築家が重視したのは別の問いである。その建物は何のためにあるのか。人はどう移動すべきか。利用者にとって理解しやすいよう、空間をどう構成すべきか。
家をわが家らしく感じさせるのは、構造上の健全性だけではない。自然光、部屋の比率、人々が集まり思い出をつくる空間も重要である。
同じような細やかな配慮がここにも当てはまる。コンテキストエンジニアリングはインフラを構築する。コンテキストアーキテクチャは、その上に置かれる情報の構造を定義する。前者がパイプラインと構成要素に焦点を当てるのに対し、情報アーキテクトが主導する後者は、構造、意味、振る舞いに焦点を当てる。
コンテキストアーキテクチャでは、以下のような問いを扱う:
- コンテキストに含めるべき概念は何か。
- それらにどのようなラベルを付け、そのラベルをユーザーの言葉にどう対応させるか。
- 概念同士はどのように関係するか。
- システムは何を記憶し、何を忘れるべきか。どの情報源をより信頼すべきか。
- システムが決して行ってはならないことは何か。
情報アーキテクトは、どのようなメタデータを用意するか、エンティティ同士をどう関連づけるか、その構造をユーザーのメンタルモデルにどう反映させるかを定義し、最終的にモデルの効率と精度を高める。たとえば、よく設計されたタクソノミーがあれば、エンジニアはカスタマーサポート文書全体を検索するのではなく、請求に関する異議申立てに関連するポリシーだけを取得できる。これにより検索ノイズが減り、応答精度が高まる。同様に、ユーザーのメンタルモデルに合うラベルは、タスクに適したスキルの呼び出しに役立つ。たとえば、スキル名を「credential-recovery workflow」ではなく「reset password」とすれば、「ログインできない」というユーザーの言葉に、システムがそのスキルを対応づけやすくなる。
AIシステムが日常的なプロダクトに組み込まれるにつれ、情報アーキテクトとコンテキストエンジニアの連携は不可欠になる。コンテキストアーキテクチャは、明確なプロンプトを書いたり、見出しや箇条書きで指示を整えたりすることにとどまらない。AIシステムを取り巻く情報環境全体の設計である。知識の構造、ツールのラベル、検索の仕組み、メモリーの構成、概念同士の関係までを含む。よい文章は読みやすさを高める。コンテキストアーキテクチャは、システムが情報を解釈し、判断し、振る舞う方法をかたちづくる。
AIシステムにおけるIAの原則
コンテキストアーキテクチャはIAの原則に根ざしており、コンテキストをどのように整理し、接続し、提供するかを構造的に設計する必要がある。われわれは、情報アーキテクチャの中核原則を基盤とし、AIシステム向けに調整したフレームワークを開発した。このフレームワークは、AIの急速な進歩と、構築方法を継続的に改良する必要性に応じて、現在も進化している。
このフレームワークはコンテキストのエコシステム全体に適用される。構造に問題のある情報取得の仕組み、一貫性がないラベル、重複しているツール、ノイズが多いメモリーシステムといった問題は、よく書かれたプロンプトだけでは補えない。
コンテキストの構造化
情報アーキテクトは、AIシステムがより効果的に推論できるようコンテキストを構造化する。情報が明確に整理されていれば、ユーザーとモデルの双方にとって曖昧さと認知負荷が減る。システムは入力の解釈に費やす労力を抑え、より正確な応答を生成できる。
カスタマーサポートAIエージェントを例にする。構造が明確でなければ、サポートエージェントは企業のナレッジベース全体から、関連性の弱い大量の情報を取得しかねない。
例:構造化されたコンテキストを持たないカスタマーサポートエージェント
ユーザーのプロンプト:「アカウントから締め出されてしまった」
| システムが取得する情報 | エージェントの出力 |
|---|---|
| ・古いトラブルシューティングのメモ ・廃止されたパスワードリセットの手順 ・セキュリティ上のエスカレーションの方針 ・従業員間の社内会話 | ・古い指示 ・復旧を誤らせる手順 ・不要なエスカレーション ・幻覚によって作られた手順 |
問題はモデル自体ではない。システムが、ノイズが多く構造化されていないコンテキストを解釈しなければならないことが問題である。情報アーキテクトは、システムがより確実に扱える明確な構造にコンテキストを整理し、この曖昧さを減らす。
構造化されたコンテキストは、どの情報が最も重要か、どの情報源の信頼性や優先度が高いか、概念同士がどう関係するかをシステムが理解するのに役立つ。
例:構造化されたコンテキストを持つカスタマーサポートエージェント
ユーザーのプロンプト:「アカウントから締め出されてしまった」
| IAの手法 | 役割 | 例 | 効果 |
|---|---|---|---|
| 階層化 | 情報の優先順位と深さを定める | 情報の優先順位に関するルール: ・承認済みの全社ポリシーをチームのメモより上位に置く ・現行ワークフローを廃止済み手順より上位に置く ・例外事例より先に基本的なアカウント復旧手順を提示する | 推論や検索の際に、どの情報を最も重視すべきかを特定できる。 |
| 分類 | 関連する概念を明確な領域にまとめる | コンテンツ分類: ・アカウントアクセス ・請求 ・技術トラブルシューティング ・セキュリティ ・企業管理 | サポート文書全体ではなく、より小さく関連性の高い範囲を検索できる。検索ノイズが減り、応答精度が高まる。 |
| ラベリング | システム内の言葉を、ユーザーが問題を自然に表現する言葉に合わせる | システム内のラベル: ・締め出された ・ログインできない ・パスワードをリセットする 次のような表現は避ける: ・認証情報の無効化 ・認証失敗 ・本人性復旧ワークフロー | ユーザーの言葉を内部概念に対応させやすくなり、検索とワークフロー選択が改善する。 |
見つけやすさの改善
LLMは、わかりにくいウェブサイトを利用するユーザーと同様に、情報の見つけやすさに苦労することが多い。AIエージェントが誤った情報を取得したり、不要な手順を実行したりすることを防ぐ必要がある。エージェントが情報をすぐに見つけられれば、精度と効率が高まる。見つけやすさの改善は、正しいコンテキストを取得する前に処理しなければならない無関係な情報を減らし、システムの負荷も軽減する。
コンテキストのエコシステムの一層であるスキルを見てみる。カスタマーサポートAIエージェントの例では、見つけやすさを高めることで、システムはユーザーの要求に合うスキルをすばやく特定できる。スキル名や説明が曖昧または重複していると、エージェントは誤ったスキルを選び、不必要な質問をしたり、特定の問題に対処せず広範なサポート文書を検索したりする恐れがある。
例:スキルを見つけるためのIAの支援がないカスタマーサポートエージェント
ユーザーのプロンプト:「アカウントから締め出されてしまった」
| スキル | エージェントの振る舞い |
|---|---|
| 名前:account-support 説明:アカウントの問題に使用する。 名前:customer-help 説明:顧客が支援を必要とする場合に使用する。 名前:access-workflow 説明:アクセス関連のワークフローに使用する。 | スキル同士を区別しにくいため、エージェントは誤ったものを選択したり、不要な質問をしたり、正しいログイン用ワークフローを使わずに広範なサポート文書を検索したりする恐れがある。 |
情報アーキテクトは、コンテキストを見つけ、区別し、取得しやすくすることで、見つけやすさを改善する。
例:スキルの周辺にIA支援があるカスタマーサポートエージェント
ユーザーのプロンプト:「ログインできない」
| IAの手法 | 役割 | 例 | 効果 |
|---|---|---|---|
| タクソノミー | 関連するスキルを明確な分類にまとめる | アカウントアクセス: ・reset-password ・unlock-account ・verify-identity 請求: ・update-payment-method ・refund-request ・subscription-change | 特定のスキルを選ぶ前に、検索範囲を絞れる。 |
| 統制語彙 | 同じ概念について、システムがユーザーと同じ用語を使うようにする | 名前:account-access-support 説明:ユーザーがログインできない、締め出された、パスワードのリセットが必要、またはアカウントへのアクセスに問題がある場合に用いる。 | 「ログインできない」などのユーザーの言葉を、正しい内部概念へ結びつけられる。 |
| 曖昧さのない命名 | 各スキルを比較し、呼び出しやすくする | 名前:reset-password 説明:パスワードのリセット、復旧、変更が必要な場合だけ用いる。 名前:unlock-account 説明:ログイン失敗後に締め出された場合だけ用いる。 | 明確な名前によって重複が減り、適切なスキルをより速く選べる。 |
ユーザーのメンタルモデルとの整合
コンテキストの概念モデルとは、どの情報が重要か、情報同士がどう関係するか、やり取りのどの時点で特定の情報を使うべきかについて、システムが内部に持つ表現である。
コンテキストアーキテクチャの重要な要素の1つは、システムの内部モデルをユーザーのメンタルモデルに合わせることである。実務では、ユーザーが問題を自然に表現し、期待を形成し、タスクを進める方法に沿ってコンテキストを構造化することを意味する。
カスタマーサポートAIエージェントの例では、この整合が不可欠である。システムは、ユーザーの言葉と意図を適切なツールに正しく対応させなければならない。システムはツールや接続サービスを利用でき、それぞれに使用時期を判断するための説明とメタデータがある。しかし、ツールの説明が一貫せず、専門的すぎる場合がある。システムの概念モデルがユーザーの言葉ではなく社内の技術用語を反映しているため、エージェントが誤った行動を取る恐れがある。問題はツールやMCP(model-context protocol)連携が不足していることではない。コンテキスト層の説明、ラベル、関係がユーザーのメンタルモデルに合っていないことなのである。
例:カスタマーサポートエージェントの内部モデルがユーザーのメンタルモデルと合っていない
ユーザーのプロンプト:「ログインできない。急いで助けてほしい」
| ツールの説明 | AIエージェントの出力 |
|---|---|
| ・認証情報復旧ワークフロー ・認証状態の遷移を処理する ・本人確認シーケンス ・本人確認エスカレーションプロトコルを起動する | ・誤ったツールを選ぶ ・高コストなワークフローを起動する ・わかりにくい確認質問をする ・「ログインできない」がアカウントアクセスの復旧に対応すると認識できない |
情報アーキテクトは、ツールの構造と用語を、ユーザーが自然に考え、伝える方法に合わせる。ユーザーの考え方に対応する分類へツールを整理し、内部の説明文もユーザーの言葉に合わせることがある。
例:カスタマーサポートエージェントの内部モデルがユーザーのメンタルモデルと合っている
ユーザーのプロンプト:「ログインできない。急いで助けてほしい」
| IAの手法 | 役割 | 例 | 効果 |
|---|---|---|---|
| タクソノミー | ユーザーが直感的に認識できる分類へツールを整理する | アカウントアクセス: ・reset-password ・unlock-account ・verify-identity 請求: ・request-refund ・update-payment-method | 関連するツール群を絞ってから、一つを選べる。 |
| オントロジー | 概念同士の関係を定義する | ・「ログインできない」はアカウントアクセスに関係する ・複数回のログイン失敗でアカウントがロックされる場合がある ・緊急のアクセス問題には優先的なエスカレーションが必要な場合がある | 意図を推論し、ツールを正確に選べる。 |
| ラベリング | ツール名と説明をユーザーの言葉に合わせる | ・credential-recovery workflowではなくreset-passwordを用いる ・authentication-state-managerではなくunlock-accountを用いる | 用語を合わせることでツール選択が改善し、曖昧さが減り、やり取りがより自然になる。 |
メモリーの設計
メモリーは、時間をまたぐ継続性と関連性を左右する。構造が明確でなければ、システムは重要な情報を忘れるか、無関係な詳細で過負荷になる。システム指示を用いて、次を定義する。
- 何を記憶するか
- どのようにインデックス化するか
- いつ取得するか
会話が長くなり、ユーザーが同じチャット内で作業を続けるにつれて、メモリーの構造化はますます重要になる。チームは、AIシステムが知る必要があることと、忘れる必要があることを決めなければならない。
カスタマーサポートエージェントの例では、メモリーに関する明確な指示がないと、重要な長期情報を犠牲にして、過去の会話からすべてを取得する恐れがある。会話が長くなるにつれて、メモリーからの取得にはノイズが増え、一貫性が失われる。問題はメモリー自体ではない。何を長期的に残すべきかを管理する構造がないことである。
例:ノイズが多く一貫性のないメモリー層を持つカスタマーサポートエージェント
再度問い合わせたユーザーのプロンプト:「まだアカウントにアクセスできず困っている」
| メモリーから取得された情報 | AIエージェントの振る舞い |
|---|---|
| 無関係な情報: ・過去のトラブルシューティング ・期限切れの請求に関する異議申立て ・無関係な技術的な問題 関連する情報: ・アクセシビリティ設定 ・希望する連絡方法 ・企業アカウントの状態 | ・無関係な情報を提示する ・重要な顧客設定を見落とす ・トークン使用量と待ち時間が増える |
情報アーキテクトは、保持、取得、関連性について明確なルールを持つメモリーシステムを設計し、目の前のタスクに必要な情報だけを取得できるようにする。
例:構造化されたメモリーを持つカスタマーサポートエージェント
再度問い合わせたユーザーのプロンプト:「まだアカウントにアクセスできず困っている」
| IAの手法 | 役割 | 例 | 効果 |
|---|---|---|---|
| ファセット分類 | メモリーを異なる種類に整理する | ・アクセシビリティ設定 ・請求履歴 ・セキュリティ確認 ・対応中のサポート案件 ・一時的なトラブルシューティング手順 | 現在のタスクに関連するメモリーだけを取得できる。 |
| スコープ規則 | メモリーを利用可能にする時期を定める | ・一時的なトラブルシューティングの詳細は、現在のセッション内だけで参照する ・アクセシビリティ設定は会話をまたいで保持する | 無関係な情報が今後のやり取りに混入しない。 |
| 保持方針 | 情報の種類ごとに保持期間を定める | ・パスワードリセットのトークンは短時間で失効する ・対応中の請求に関する異議申立ては解決まで参照可能にする ・解決済みサポートチケットはアーカイブする | 継続性と、関連性およびプライバシーとのバランスが取れる。 |
こうした取り扱いの適用方法を、システムとユーザーの双方が把握できるようにすべきである。明確で目に見えるメモリー規則があれば、どの情報が保持され、なぜ重要で、時間の経過とともにどう使われるかをユーザーが理解でき、最終的にプロダクトへの信頼を築く助けとなる。
コンテキストは決して中立ではない
コンテキストを設計する際の意思決定は、システムがタスクをどう解釈するかをかたちづくり、その出力に直接影響する。コンテキスト設計には次が含まれる。
- 選択する名称
- 定義する関係
- 組み込む制約
これらは中立的な決定ではない。意味がどのように構築され、結果がどのように生み出されるかを決める。これは設計の仕事であり、そのように扱う必要がある。
AIは新しいツールをもたらすが、根本的な課題は変わらない。われわれは今も、人間の目的にかなうよう情報を整理している。違いは、AIシステムも能動的な参加者となり、その構造を解釈して行動する点にある。
コンテキストアーキテクチャは、テクノロジー、ビジネス、人間の意図が交差する場所にある。意味のあるAIプロダクトは、コンテキストアーキテクチャによってかたちづくられる。
情報アーキテクトは、これまで以上に必要とされているのである。
記事で述べられている意見・見解は執筆者等のものであり、株式会社イードの公式な立場・方針を示すものではありません。